삼성이 선보인 새로운 연산 HBM, aHBM의 중요성
코일즈
2026.08.24
삼성이 최근 발표한 aHBM(계산하는 HBM)은 전력 효율성과 성능 향상이라는 두 가지 키워드를 가지고 있습니다. 이 기술은 GPU 연산을 보다 효율적으로 수행할 수 있는 새로운 메모리 아키텍처로, AI 및 머신러닝 애플리케이션의 성능을 크게 개선할 것으로 기대됩니다.
aHBM의 기술적 배경
기존의 HBM(High Bandwidth Memory)은 메모리의 대역폭을 개선하기 위해 여러 개의 DRAM 칩을 수직으로 적층하여 설계되었습니다. 하지만 데이터 전송속도가 증가함에 따라, CPU와 GPU 간의 데이터 이동이 큰 병목 현상을 일으키는 경우가 많았습니다. aHBM은 이런 문제를 해결하기 위해 메모리 내부에서 연산을 수행할 수 있도록 설계되었습니다. 이로 인해 GPU와 메모리 사이의 데이터 이동을 줄이는 동시에, 전력 소비도 크게 절감할 수 있습니다.
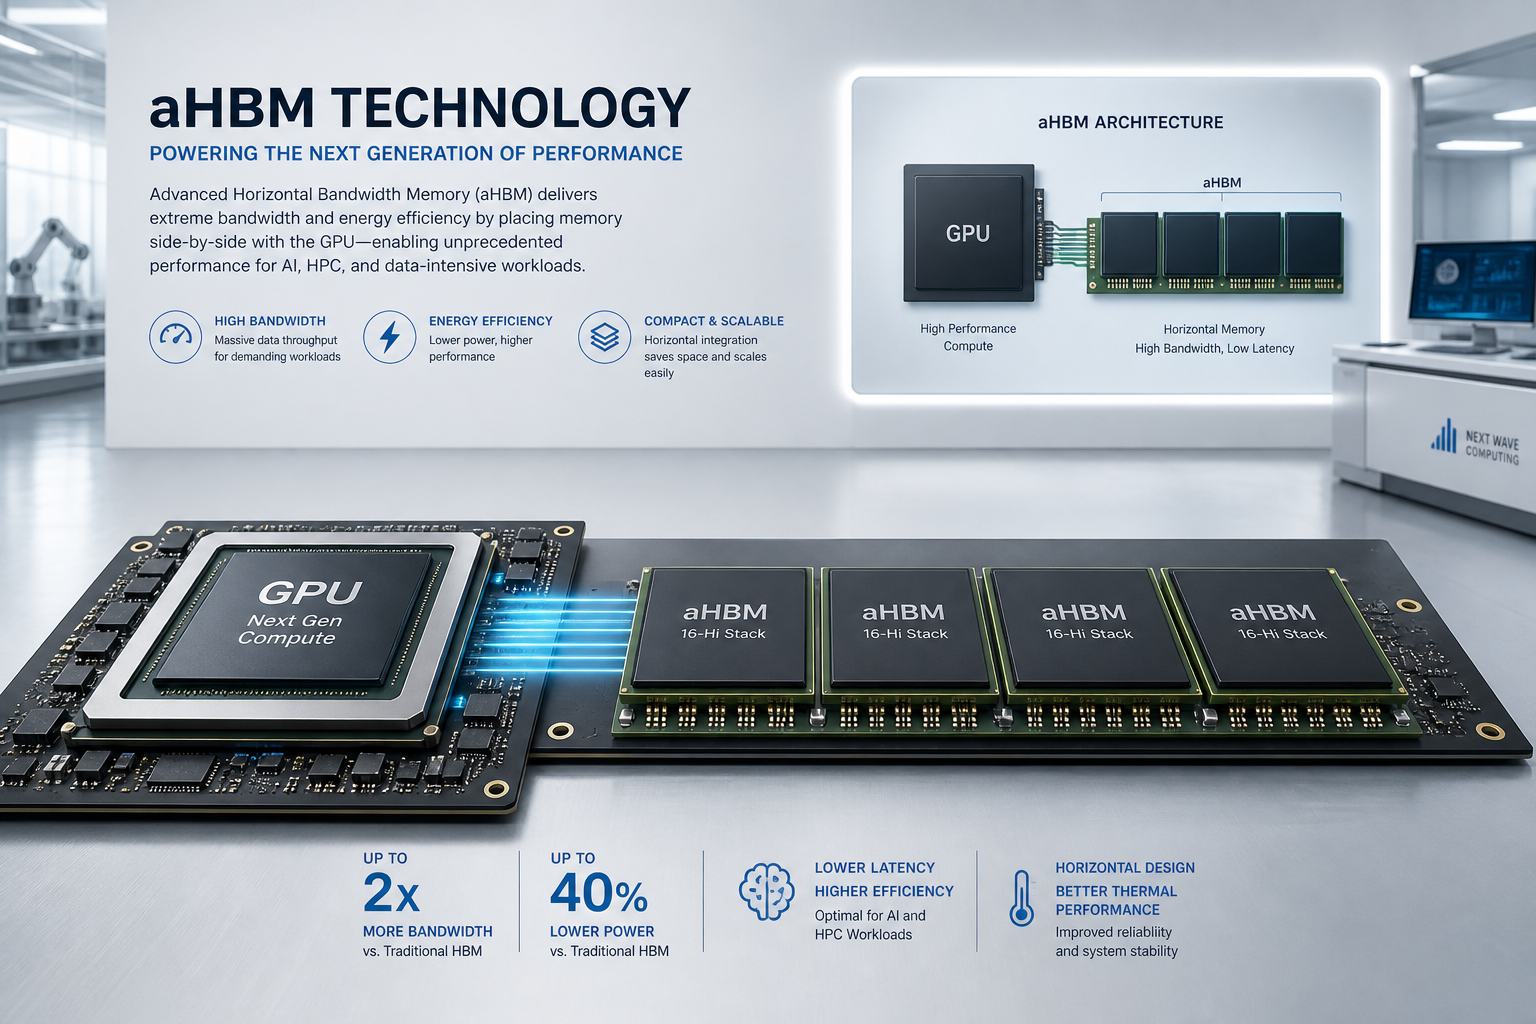
aHBM 기술을 활용한 GPU 연산의 모습
실무에서의 고려사항
설계자나 기업 담당자는 aHBM을 사용할 때, 메모리 대역폭과 전력 효율성을 함께 고려하는 것이 중요합니다. 특히 AI 데이터센터에서는 대량의 데이터 처리가 이루어지므로 이러한 새로운 아키텍처가 얼마나 효과적으로 적용될 수 있을지 주목해야 합니다.
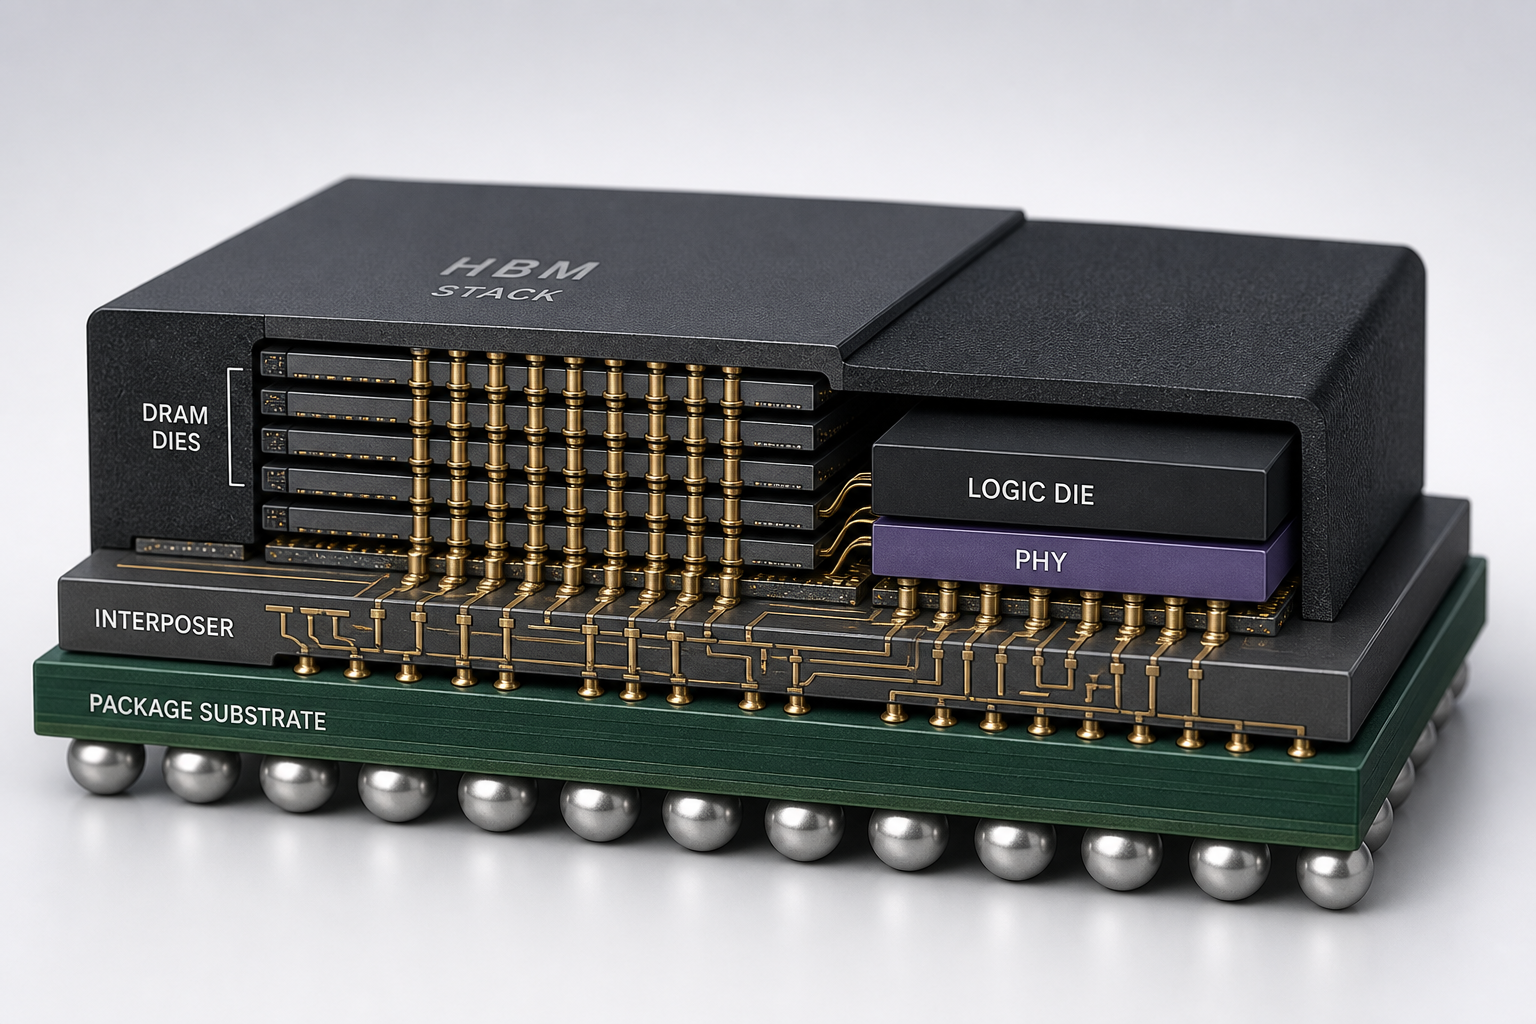
반도체 패키지의 세부 모습
aHBM은 GPU와의 통합에서 발생할 수 있는 성능 저하 문제를 최소화하고, 연산을 메모리 쪽으로 오프로드함으로써 AI 반도체의 효율성을 높이는 데 기여할 것입니다. 따라서 앞으로의 설계 및 개발 과정에서는 aHBM의 활용 가능성을 충분히 검토해야 할 것입니다.